
拒绝无源幻觉:基于原文回溯的长文档信息抽取验证协议与 gpt-6-luna 自测指南
本文最后更新于 2026-09-23,文章内容可能已经过时。
拒绝无源幻觉:基于原文回溯的长文档信息抽取验证协议与 gpt-6-luna 自测指南
在各类大语言模型应用中,长文档处理(如长篇财报解读、法务合同审查、科研文献综述)常被视作检验模型综合能力的高频场景。然而,在实际工程与业务落地时,最致命的风险往往不是模型直接报错或拒绝回答,而是它以极其工整、笃定的语气,输出了看似高度合理、实则在原文中查无出处的“伪事实”与“拼接引用”。
当文档跨越数万字,人工逐字核对的成本高昂,业务人员极易在不知不觉中采纳了带有隐蔽偏误的摘要,导致下游决策失误。
面对这一困境,破局的关键不在于盲目相信新模型ID的宣传标签,而在于建立一套可复验、可量化、机械化执行的证据回溯评测协议。本文将拆解如何设计结构化提示词约束、构建证据三维核验表,并基于当前聚合平台已开放接口的 gpt-6-luna 模型 ID,提供一套读者可自行复现的抽取可靠度验证方案。
---
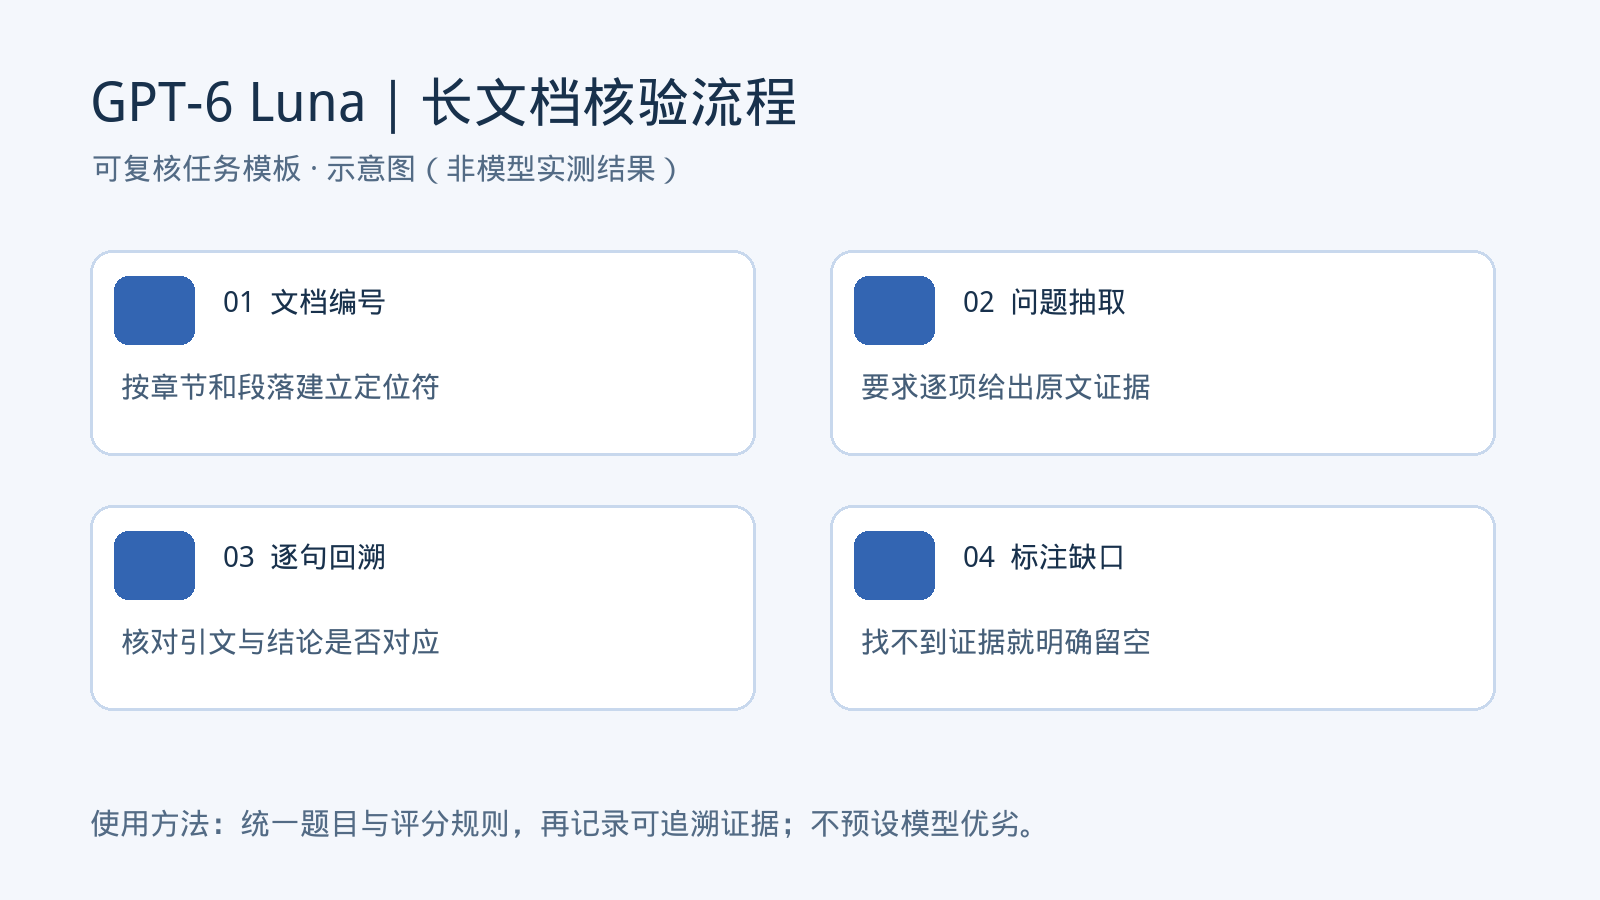
评测图示:可复核的检查流程
1. 评测前提与长文本验证的“真伪命题”
在开始任何测试设计之前,必须明确工程评测的基本边界与科学审慎态度。
免责声明
本文为长文本可靠性评测方法与提示词工程讲解,未进行独立跑分或对照实测。模型性能、上下文上限及计费标准以平台实时接口与控制台数据为准。文中涉及的输入案例与判定输出均为演示协议流程的构造性示例,不代表该模型在特定测试集下的官方统计学表现。
目前,部分第三方中转及聚合 API 平台(如 8848AI)已在模型列表中上线了 gpt-6-luna 这一模型 ID。但截至目前,官方渠道并未发布针对该模型 ID 的公开技术白皮书、底层权重架构说明或标准基准跑分。因此,仅凭接口名称的存在,不能推导其必然具备特定的参数规模、窗口长度或超越现有主流架构的推理能力。
在长文本评测中,开发者常陷入两个认知误区:
1. 误区一:能吞吐长文本 = 能理解长文本。API 接受 30,000 Token 的上下文且成功返回 200 字摘要,只代表其工程通道未超时,不代表模型未在中间段落发生注意力衰减(即典型的“大海捞针”迷失现象)。
2. 误区二:语言流畅 = 内容保真。高语言表征能力的模型极擅长根据行业常识“脑补”合理情节。在没有强制约束的情况下,它可能会将 A 公司的财务数据套用至 B 部门的经营回顾中。
因此,长文本信息抽取的评测底线应当是:无原文证据定位,即视为无效输出;无法精确复原上下文语义,即视为抽取失败。
---
2. 设计回溯协议:结构化输入与定位提取提示词
为了让模型的抽取结果具备“可审计性”(Auditability),测试者必须剥夺模型“自由发挥”的空间,通过 Prompt 强制其按结构化标准输出证据链。
2.1 测试样本的构造原则
读者在自行准备长文本测试集时,建议遵循以下三项样本构建原则:
- 长度梯次分布:准备 5,000 字、10,000 字至 20,000 字不同量级的文档,观察随着文本增长,模型对中后段细节的捕获能力。
- 制造多主体冲突:样本内应包含实体相似但结论相反的段落(例如:文档前半部分讨论“A 方案在 2023 年测试失败”,后半部分讨论“改进型 A 方案在 2024 年实现微利”),专门用于捕捉模型的“张冠李戴”现象。
- 设定反事实/生僻锚点:在长文中埋入一些不符合通识的设定(如某虚拟实验中设定的特定反常物理参数),检验模型是依据原文提取,还是被模型预训练权重中的外源先验知识带偏。
2.2 标准化定位提取 Prompt 模板(示例)
以下为一套可直接复用于 API 调用的系统级提示词方案。该方案要求模型将每一项事实主张拆解为四元组:结论、原文章节/段落定位、原文逐字微切片、置信度自评。
[System Role]
你是一名严格遵循证据主义的文献核验审计员。你的核心任务是从用户提供的长文档中,针对指定目标问题提取事实结论。
[Constraints & Execution Rules]
1. 零常识注入:你不得使用任何未在输入文本中明确出现的先验知识。如果原文未提及某信息,直接输出“无直接证据”,严禁合理推测。
2. 逐句证据绑定:输出的每一条事实结论,必须同时提供该结论直接对应的原文逐字切片(Verbatim Excerpt)。
3. 严格字数限制:原文切片必须控制在 15 至 45 个字以内,必须与原文完全一致,包含标点符号,禁止概括性改写。
4. 结构化输出:必须严格按照以下 Markdown 字段格式返回,不得增删字段,也不得输出额外的开场白或总结词。
[Output Schema]
针对提取项,按以下格式逐条输出:
- 事实编号:[序号]
- 核心结论:[用客观陈述句提炼的事实,控制在 50 字以内]
- 章节/位置定位:[标明该事实位于原文的大致结构,如第 X 节 / 表格 Y / 第 Z 段]
- 原文精确切片:"[原文逐字截取的内容,15-45字]"
- 提取置信度:[确定/存疑](若上下文存在冲突或限定条件,必须标注为存疑并简述原因)
---
3. 三步证据核验表与失败复测法
获得模型的抽取结果后,使用者不应直接肉眼浏览,而应建立流水线式的三步核验清单(Checklist),对输出的每一个切片进行真伪判定。
3.1 证据回溯三维核验表
| 维度 | 核查目标 | 验证方法 | 判异标准(满足其一即扣分) | | :--- | :--- | :--- | :--- | | 1. 引用存在性(Existence) | 验证切片真实性 | 使用代码或文本检索工具(如
Ctrl + F)在待测长文档全文中对模型输出的原文精确切片进行精准子串匹配。 | - 子串在全文匹配结果为 0 次。- 存在同义词替换、字词调换(伪造逐字引用)。
- 存在跨段落生硬拼接成单一句子的情况。 | | 2. 语境保真度
(Context Fidelity) | 验证语义无断章取义 | 找到切片所在段落,阅读其前后各 150 字的完整上下文,核查限定条件。 | - 原文为假设句(如“如果实施…”),模型提取为肯定事实。
- 原文带有转折限定(如“但该数据受限于样本偏差”),模型隐去负面约束。
- 偷换主语或时间范围。 | | 3. 边界严谨度
(Boundary Rigor) | 验证外源知识隔离 | 检查
核心结论中出现的核心术语、数据、关联逻辑,是否完全被原文精确切片覆盖。 | - 结论中出现了切片中未包含的技术参数或衍生结论。- 引入了行业公认但文档未写的先验定义。
- 将弱相关强行归因为因果关系。 |
3.2 失败复测与定位修复方法
在实际自测过程中,若模型在某些长文本测试用例中出现“引用匹配失败”或“断章取义”,不应急于判定其完全失效,而应执行标准化追问与边界探测。
以下是针对抽取失败的修复与压测 Prompt 示例:
[User Prompt - 追问复测指令示例]
在刚才的输出中,事实编号 [N] 的“原文精确切片”未能在输入文档中精准检索到子串匹配。

请重新核查文档,并执行以下复测逻辑:
1. 请重新定位包含该核心结论的原始段落,并输出该段落前后 100 字的完整原文。
2. 若核查后发现原文并未明确包含该结论的直接文字支撑,请显式返回:
“【事实撤回】:原文无直接证据支持该结论,此前输出属于推断溢出。”
3. 严禁基于上下文进行二次合理化包装。
通过这一层追问,测试者可以直观观察该模型在面对提示词质疑时,是具备主动撤回与纠偏机制,还是陷入更深层次的“幻觉自圆其说”。这一表现是评估长文本工程可用性的核心指标。
---
4. 接口调用实践与自测成本控制
为了让开发者能够快速将上述协议工程化,以下提供基于 Python 标准 SDK 接入 gpt-6-luna 进行自动化定位抽取的脚本模板。
4.1 Python 调用脚本模板
import os
import sys
from openai import OpenAI

初始化客户端
聚合平台接口与密钥配置
client = OpenAI(
api_key=os.environ.get("OPENAI_API_KEY", "your-api-key-here"),
base_url="https://api.884819.xyz/v1",
)

def run_extraction_audit(document_text: str, query: str):
"""
长文档抽取可靠性自测执行函数
"""
system_instruction = (
"你是一名严格遵循证据主义的文献核验审计员。你的核心任务是从用户提供的长文档中,"
"针对指定目标问题提取事实结论。必须严格输出四元组:核心结论、章节定位、"
"原文精确切片(15-45字逐字匹配)、提取置信度。无证据则输出'无直接证据'。"
)

user_content = f"【待审计文档开始】\n{document_text}\n【待审计文档结束】\n\n问题:{query}"

try:
response = client.chat.completions.create(
model="gpt-6-luna",
messages=[
{"role": "system", "content": system_instruction},
{"role": "user", "content": user_content},
],
# 设为 0 以最大程度降低随机性,确保可复现性与定位一致性
temperature=0,
# 根据提取项多寡设定上限,防止无意义发散
max_tokens=2048,
timeout=120.0,
)
return response.choices[0].message.content

except Exception as e:
print(f"[调用异常] 错误信息: {str(e)}", file=sys.stderr)
return None

if __name__ == "__main__":
# 此处仅作调用格式示范,长文本请自行传入真实业务切片
sample_doc = "(此处插入 5,000 - 20,000 字的测试样本内容)"
test_query = "提取文中提及的所有系统崩溃应急处置步骤及对应责任人"

result = run_extraction_audit(sample_doc, test_query)
print("----- 抽取结果输出 -----")
print(result)
4.2 自测成本与上下文控制策略
在进行长文本工程验证时,成本与调用开销必须纳入前期考量:
1. Token 消耗非线性上升:长文档评测涉及大量输入 Token。单次发送 20,000 字的技术文档,其单次请求计费主要由 Prompt 长度决定。因此在设计测试流程时,切忌一开始就进行全量并发测试。
2. 费率与上下文支持确认:在聚合 API 平台(如 8848AI)上,所有模型的具体价格、输入/输出 Token 单价及单次请求允许的最大上下文长度,均受上游通道波动影响。自测前必须前往平台控制台查看实时计费说明与限制参数,切勿脱离控制台页面假设固定成本。
3. 分段试水原则:建议先用 3,000 字的标准对照集验证提示词遵循能力与返回格式一致性;确认其能稳定输出符合规格的“原文切片”后,再逐步提高输入文本长度,阶梯式排查注意力衰减阈值。
---
5. 结语:从“迷信模型”走向“框架约束”
在当下模型层出不穷的环境中,我们容易产生一种错觉:只要等待下一个版本号更大的模型出现,一切幻觉与可靠性问题就会迎刃而解。
但工程实践反复证明,任何基于概率分布预测下一个 Token 的大语言模型,在缺乏外部强约束与审计闭环时,都不可能做到 100% 的绝对保真。模型的可靠度,从来不是单纯由模型本身决定的,而是由“模型能力 × 提示词工程约束 × 外部核验框架”共同构筑的。
面对类似 gpt-6-luna 这样新进入开发者视线的模型 ID,最科学的应对方式既不是盲目神化,也不是在没有测试基准的前提下全盘否定。通过本文提供的结构化提示词与三维证据核验表,每一位工程师与高级用户都可以低成本建立属于自己的测试流水线,用清晰的事实比对代替主观感受。
想要亲自验证长文本摘要的真实定位表现?当前 gpt-6-luna 接口已在聚合 API 平台上线。读者可前往 api.884819.xyz 获取测试 API Key,导入文中的测试框架与提示词模板进行自主验证。请注意:模型调用额度与计费以平台实时控制台页面为准,建议先以小批量文本完成回溯流程校验。
---
解决长文档的引用回溯,只是评估复杂任务的第一步。当模型面对长代码工程、跨多表数据库架构等“多跳逻辑推理”场景时,又该如何设计严苛的单元测试集来捕捉隐蔽错误?下一期,我们将带来面向复杂逻辑链路的“边界容错与反事实注入”评测体系设计,敬请关注。
本文由8848AI原创,转载请注明出处。关注8848AI,带你从零开始学AI。#长文档处理 #Prompt技巧 #幻觉消除 #API实践 #8848AI #人工智能 #知识库搭建




